

1 前言
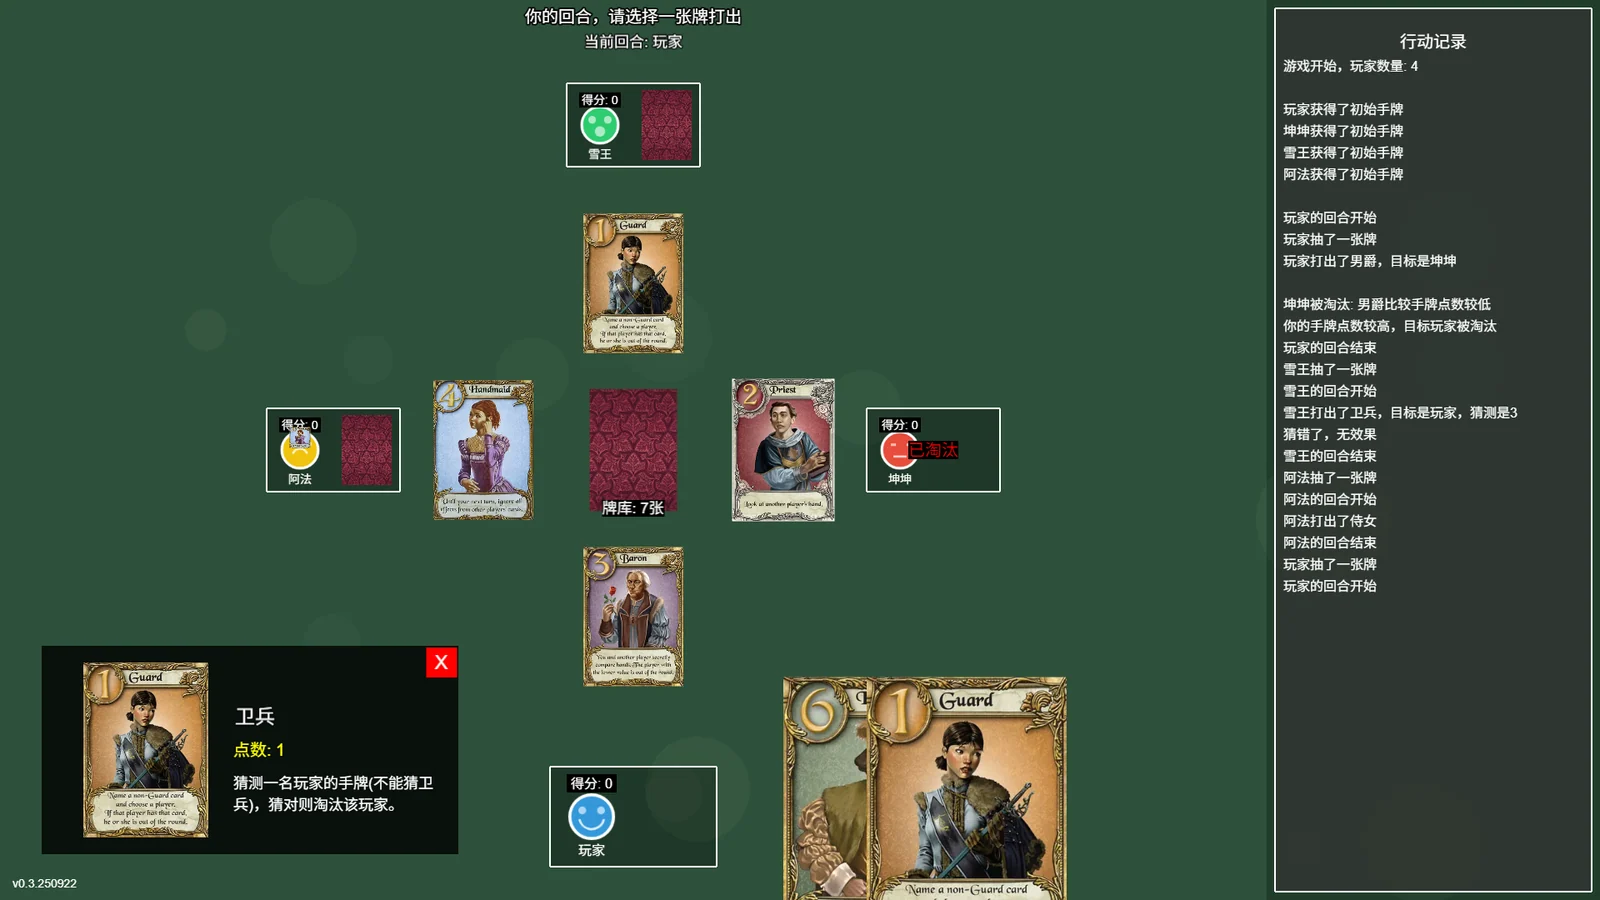
直接与人机试玩:https://sct.ctm49.com/loveletter/
作为一名桌游爱好者,同时又对 AI 比较有兴趣,于是开发一个游戏 AI 就提上了日程。AlphaGo、Stockfish 等棋类 AI,NAGA、Suphx 等麻将 AI,以及 Alphastar 等等,无不证明 AI 在游戏领域可以给出一个“标准答案”,更深刻地改变了我们学习和理解游戏的方式。过去,我们习惯于通过经验积累、公式推导来提升棋艺,如今则可以借助 AI 进行复盘、打谱,衍生出人类从未探讨过的策略和下法(例如围棋的点 33 新定式)。AI 的加入,让游戏的学习范式焕然一新,也让每一位玩家都能与“最强大脑”切磋较量。
在这样的背景下,对于常玩的一些桌游,我也想找到它的“标准答案”。此外桌游这种东西,能找到人玩也很难,找到“会玩”的人更难。于是我也想开发一些比较厉害的 AI 来跟我博弈。那么,本文就来分享我在学习和开发《情书》(LoveLetter)AI 过程中的过程和心得,能给大家带来一些启发最好。
2 基础知识学习
有句话叫做“如果学一个东西觉得难,那是你还没有准备好学习它”。在开始训练一个 AI 前,我觉得学习一些强化学习的基础知识是必不可少的,不然遇到问题都不知道问什么。于是首先在网上寻找一些强化学习的书籍和讲解:邱锡鹏《神经网络与深度学习》(https://nndl.github.io/)、邹伟《强化学习》这两本书相对来说比较好读易懂。如今的 GPT 也非常强大,不懂就问 AI 极大地加快了我的学习过程。马尔可夫决策过程(MDP)、价值函数、策略和 Q-learning 这些最基础的有所了解,就差不多可以开启实战了。
3 《情书》游戏简介
《情书》桌游(https://www.zmangames.com/game/love-letter/)是一个规则相对简单,但其策略深度和博弈难度确是非常大的不完全信息博弈游戏。所谓不完全信息博弈就是不知道一个游戏状态的所有信息,这意味着从一个玩家视角看到的游戏状态,可以对应多个实际的游戏状态。于是要从不完全信息中构建一个强力的策略,来击败对手,这相对于完全信息博弈游戏(例如象棋、围棋)要难得多。
那什么是不完全信息博弈的 SOTA(State of the Art,可以理解为最优解)呢?——对于牌类的动态不完全信息博弈,其 SOTA 是完美贝叶斯均衡(Perfect Bayesian Equilibrium):每个玩家都会采取最优的行动,并根据先验概率、观察到的行动更新自己的信念,即对未知信息的概率估计。
简而言之,就是根据其他玩家的行动去推测手牌,然后做出收益最高的决策。这个决策也是一个混合策略,就像石头剪刀布不能只出石头一样,也要让对手猜不透自己。
而《情书》就是众多动态不完全信息博弈的代表。基本规则如下:
轮到玩家时,抽一张牌,然后从手中两张牌中选择一张打出,执行其效果。部分卡牌效果会让玩家淘汰出局,最后剩下的玩家或牌堆用尽时,手牌点数最高者获胜。
- 侍卫(1 点,5 张):猜测一名玩家的手牌,猜中则其淘汰。
- 牧师(2 点,2 张):查看一名玩家的手牌。
- 男爵(3 点,2 张):与一名玩家比大小,点数低者淘汰。
- 侍女(4 点,2 张):本回合免疫其他玩家效果。
- 王子(5 点,2 张):指定一名玩家弃掉手牌并重新抽一张。
- 国王(6 点,1 张):与一名玩家交换手牌。
- 女伯爵(7 点,1 张):若与王子或国王同手,必须打出伯爵夫人。
- 公主(8 点,1 张):若打出或弃掉则立即淘汰。
可以看出,这个游戏抽 1 打 1,本身能做的决策并不多,动作空间比较简单。但要赢一局游戏,却需要对对手的手牌有足够好的推测,通过 1 侍卫猜测、3 男爵拼点,或者将大牌留到最后来获得胜利。
4 RLCard 框架和结构
RLCard 框架(https://github.com/datamllab/rlcard)是一个非常好用于训练牌类游戏的框架,内置了像斗地主、UNO、Texas Hold’em 之类的牌类游戏。并且自带 Deep Monte-Carlo (DMC)、Deep Q-Learning (DQN)、Neural Fictitious Self-Play (NFSP)、Counterfactual Regret Minimization (CFR) 算法。基本上只需要写好游戏环境和 AI 的输入、输出大小,就可以直接开始训练了,省去了实现各种算法的时间。
快手团队也是利用它基于 DMC 算法训练了一个 DouZero(https://github.com/kwai/DouZero),斗地主 AI。我玩了两盘它的 DEMO(https://www.douzero.org/)也算比较厉害。
对于一个牌类游戏,在 RLCard 框架下主要由环境、游戏、回合构成。交互方式主要是:模型-训练脚本-环境-游戏-回合,训练脚本初始化模型,从游戏环境中获取状态,交给模型去决策,然后将决策返回环境。环境创建一局游戏,并循环进行回合,再调用玩家、卡牌、发牌员等类进行游戏,直到游戏结束由裁判决定胜负和奖励。进行一局游戏后,生成一系列的训练样本交给模型去训练。
对于不了解的框架或项目,我非常推荐 PocketFlow-Tutorial-Codebase-Knowledge(https://github.com/The-Pocket/PocketFlow-Tutorial-Codebase-Knowledge),可以对一个项目进行分析并生成易于理解的中文文档,但需要 LLM API,使用免费的 Gemini 就好。原来了解一个项目到使用可能要花个几天,用它之后非常加快理解速度。
5 开发过程
5.1 游戏逻辑
在 AI 时代,开发一个新的项目也变得简单许多。在 RLCard 中,已经有了 UNO 的例子,UNO 的基本玩法(抽 1 打 1)与 Loveletter 非常接近。所以我直接复制 uno 的项目,然后要 AI 帮我改成适用于情书游戏的代码。基本上一个简单的游戏框架就搭建完了。
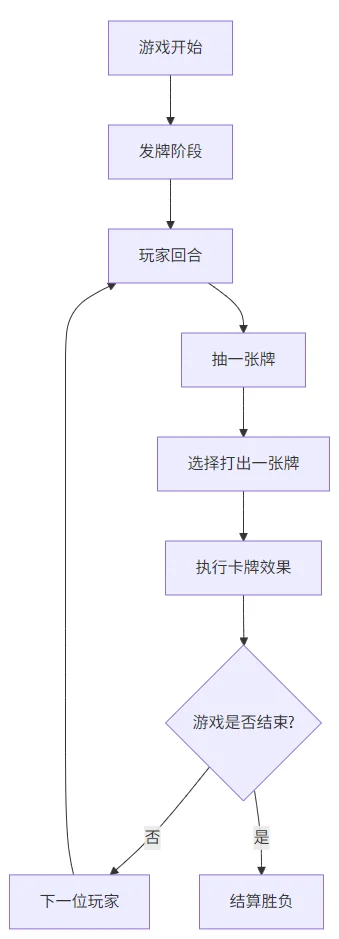
这里就重点说一下踩坑的卡牌效果处理、合法动作空间:
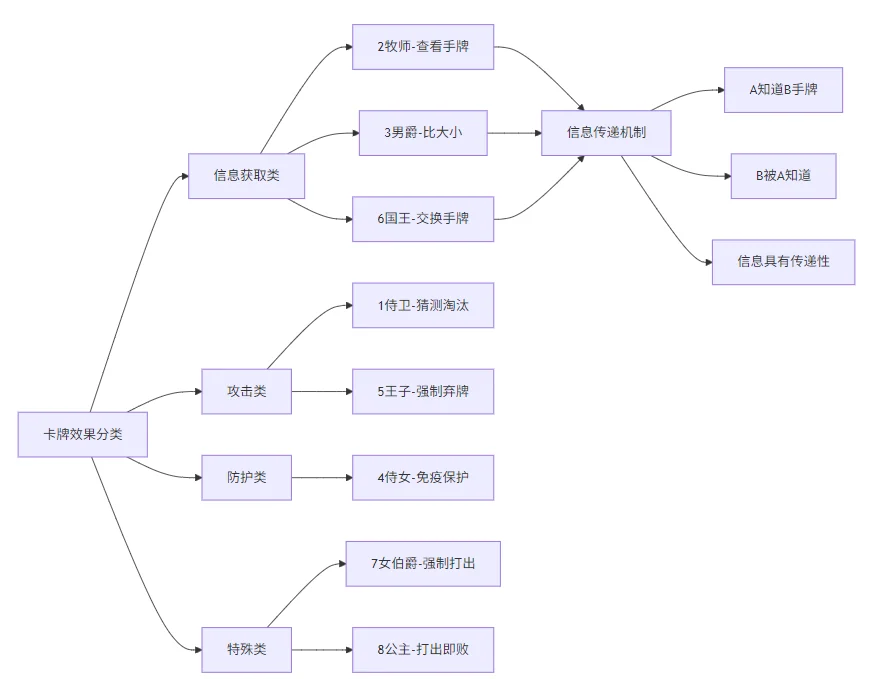
首先是信息获取类牌:2 牧师、3 男爵、6 国王。在牧师看牌、男爵拼点平局、国王换牌时,要给 A 玩家添加知道 B 玩家是什么牌的信息,以及给 B 玩家添加被 A 玩家知道了手牌的信息。男爵和国王是互知手牌,并具有传递性:A 知道 B 的手牌不是国王,B 打出国王跟 C 交换,那么 A->B 的已知信息关系就要转换到 A->C。在打出一张牌时,清除其他玩家对这个玩家、这张牌的已知信息。这样的记录就能给 AI 带来非常大的提升。
然后就是王子的弃牌结算,有两个特殊情况。如果公主被弃掉,该玩家立刻淘汰,不再抽牌。如果牌堆没牌,该玩家弃牌并淘汰。所有的打出卡牌、玩家淘汰,都需要把牌放入该玩家的弃牌堆。
合法动作空间主要分:1 侍卫,可以对其他玩家使用,并猜测 1-8。2 牧师、3 男爵、6 国王,可以对其他玩家使用。5 王子,可以对任何玩家使用(包括自己)。4 侍女、7 女伯爵、8 公主,直接打出,没有目标(或者可以认为目标是自己)。已淘汰的玩家不能成为目标,但被侍女保护的玩家仍然能成为目标,否则在其他玩家都被侍女保护的情况下,可能导致没有合法动作空间了。
5.2 训练逻辑
NFSP(Neural Fictitious Self-Play,神经虚拟自博弈),是训练两个强化学习(RL,reforcement learning)网络,DQN(Deep Q-Network)和一个监督学习(SL,supervised learning)网络。
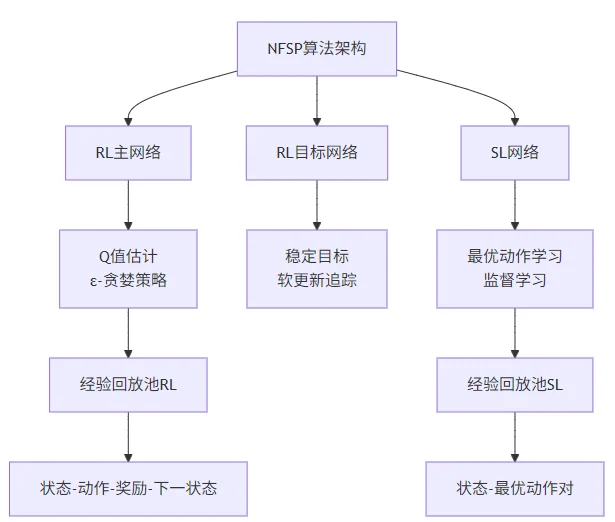
首先初始化这三个网络:RL 主网络、RL 目标网络、SL 网络。给定一个游戏局面,以一定概率(默认是 0.1)使用 SL 网络决策,否则采用 RL 主网络决策(ε-贪婪),直到游戏结束,得到 RL 经验回放池(训练样本):(状态 state, 动作 action, 奖励 reward, 下一步骤 next_state, 结束标记 done)。
当样本足够大时,采样一批样本训练 RL 主网络,RL 主网络是一个 Q(s,a) 函数,即在一个状态 s 下,选择动作 a,会得到什么样的价值 Q,Q 使用贝尔曼方程(Bellman Equation)来计算。RL 目标网络是一个更加稳定的网络,通过软更新、硬更新追踪 RL 主网络。这是因为如果使用同一个网络,Bellman 方程计算样本的 Q 值(即长期奖励)时变化会很大,导致训练过程非常不稳定甚至发散。
其中,那些使用 RL 网络决策的,并且最终是采用了当前所有合法动作中最高 Q 值(根据 RL 主网络)的那些样本,即动作 a* = argmax(a) Q(s,a),会把 (s,a*) 样本存入 SL 网络的经验回放池(训练样本)中。
那么 SL 网络就很简单了,回到我们最初的训练 AI 的目的,就是在当前状态 s 下,选择一个最佳动作 a,即训练一个 a(s) 函数。于是采样 SL 网络经验回放池中的样本,即 RL 网络决策的最佳动作样本 (s,a) 用来训练 SL 网络,这就是一个简单的分类问题网络(就像手写数字识别一样)。
这样,我们就能得到一个逐渐收敛到纳什均衡的决策模型。
当然,这些训练逻辑一开始我也没有弄得很详细,RLcard 框架已经非常完善了,只需要调用 NFSPAgent 类相关的函数,这些都会自动运行的。
5.3 状态与动作编码
游戏逻辑和网络训练相关逻辑我们都准备好了,接下来就需要一个“翻译官”,将游戏的状态、动作、奖励编码成模型训练时的输入张量。当然,其中动作还需要双向翻译,模型输出的决策还需要返回到游戏逻辑中执行。
游戏的状态是非常复杂的,有每位玩家的手牌、出牌的历史、牌堆的大小……也不是所有的游戏状态都需要喂给 AI,否则可能导致输入模型的维度特别大。另一方面,一些重要信息需要“额外地”发送给 AI,就像在 AlphaGo 中,不只是整个棋盘的局面,最近走的几步棋作为向量输入可以更快地让 AI 学会下棋。
因此,我的状态编码主要是玩家当前的私有信息、之前行动的历史、全局的状态三个模块:
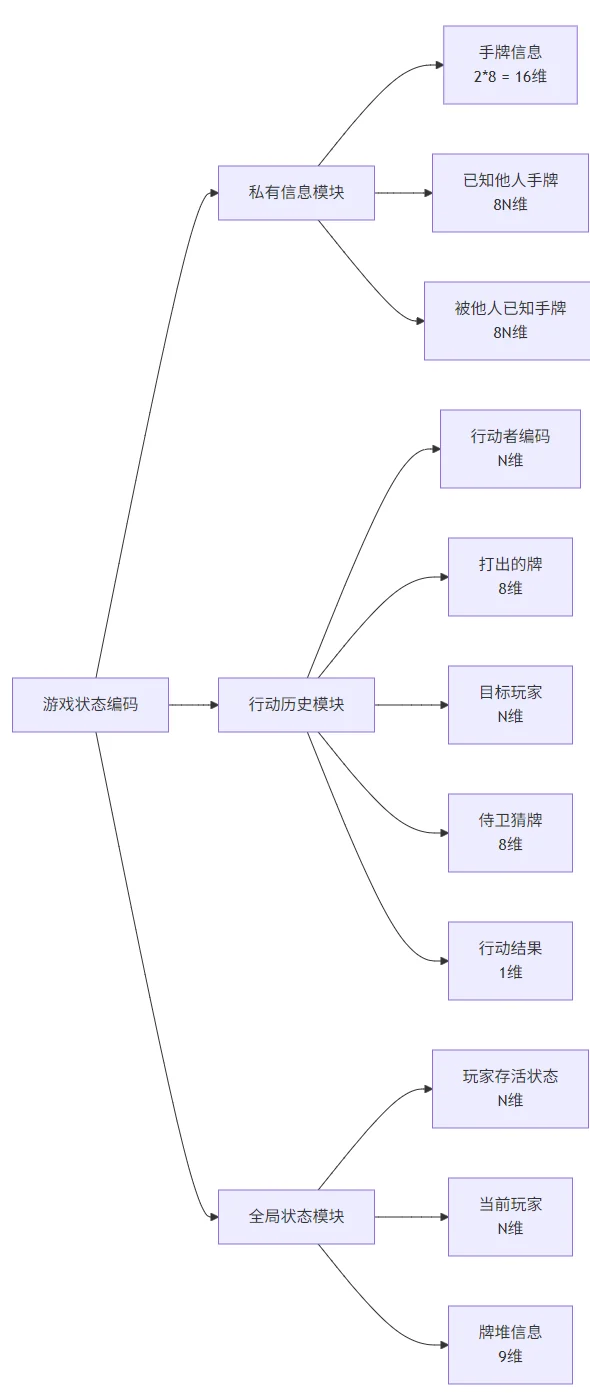
玩家的当前私有信息,一是两张手牌,使用 one-hot 编码,共 16 维。二是之前在游戏逻辑中提到的其他玩家是否知道我的手牌(按照玩家 id 排列的手牌 one-hot 编码,共 24 维),以及我是否知道其他玩家的手牌(同样是按照玩家 id 排列的手牌 one-hot 编码,共 24 维)。比如我上个回合使用牧师看了玩家 3 的手牌是 8 公主,然而再次轮到我的时候,他手上的公主牌还在,那么关于玩家 3 手牌信息就编码为 [0,0,0,0,0,0,0,1]。
行动历史部分,每个行动编码为行动者(根据玩家数的 one-hot 编码)、打出的牌(8 维 one-hot 编码)、目标(根据玩家数的 one-hot 编码,最后一维表示无目标)、侍卫猜的牌(8 维 one-hot 编码)、行动结果(是否猜中了/拼点赢了等)。为了涵盖更多动作给 AI 决策,我记录了 8 个行动历史,在 4 人游戏中,有 8*26 = 208 维。然后关于行动历史应该逆序排列(最新的行动永远编码在第一位)还是顺序排列(第一位编码的是最老的行动),我还是采纳了 AlphaGo 的顺序排列,这样可能对 AI 理解游戏进程更有帮助。
全局状态部分,一是玩家是否存活/是否受保护,按玩家数 one-hot 编码。二是当前的游戏玩家,也按玩家数 one-hot 编码。三是关于剩余牌的信息,使用牌堆剩余牌数/总牌数,代表弃牌堆大小。每种牌也将所有玩家该种类牌加起来/总牌数,蕴含着某一种牌是否打完了(就不用再猜了)。
这样整个游戏训练就可以跑起来了,接下来主要是一些超参数的调整。
6 训练超参数调整
训练的主要超参数就是整个网络的大小,小网络 [64,64] 可以迅速的收敛,但是训练出来的 AI 还是比较弱。于是选了大网络 [512,512,256],结果过拟合现象非常严重。因为没有学习到强力策略,导致 AI 收敛到一个比较弱的策略了。于是又引入了 sl 层的 dropout,有所改善。
最后采用 [512,512,256] 的网络,0.5 的 drop_out 概率,其他跟随默认设置。
agent = NFSPAgent( num_actions=env.num_actions, state_shape=env.state_shape[0], hidden_layers_sizes=[512,512,256], q_mlp_layers=[512,512,256], device=device, save_path=args.log_dir, save_every=args.save_every, rl_learning_rate=0.0001, sl_learning_rate=0.00005, q_epsilon_start=1.0, q_epsilon_decay_steps=1000000, reservoir_buffer_capacity=200000, q_replay_memory_size=200000, sl_dropout_p=0.5, )对战随机 AI,4 人局收敛到胜率 35% 左右,3 人局收敛到 50% 左右,2 人局 70% 左右。实测几盘人机对战,有些信息感觉 AI 还是没有捕捉到,没有人聪明。可能需要一些调整(网络、超参数、训练方法等)。
7 WebUI 制作
为了更方便地在线与 AI 对战,之前也开发过一些游戏,想做一个 web 版的《情书》游戏。得益于 wasm,现在 web 上也可以加载小的 AI 模型。再加上 Web 端可以说是跨平台性最强的,于是——开始开发!
在 AI 的推荐下,我选择了 Phaser.js 来开发,这个引擎非常适合 2D 游戏。由于 VSCode 的 Gemini、Copilot、CLine 等虽然比较专业,但是不交钱的话用起来非常麻烦。一下子就达到 token 上限了。最后我选择了腾讯的 CodeBuddy,虽然实力不如 Cline+Gemini Pro,但是它免费啊!当然还有一些 Cline+ 别的 API 可能也比较好用?
Codebuddy 搭建基本的场景很丑,AI 在设计 UI 这一块还是比较差,调了很久才调成现在这样的 UI。虽然还有很多不足,但至少能玩。要优化成非常丝滑的卡牌游戏 AI 太难了,遂放弃。然后就是专注于游戏逻辑的实现了。
游戏逻辑+AI 逻辑也算比较简单,直接复制 Python 的代码,让 AI 适配到 Phaser.js 中就行。当然,还是有许多需要 debug 的地方。Python 的有些代码逻辑(数组、条件分支、循环等)与 Javascript 不同,要完美移植还得一步一步打印中间变量。确保游戏状态 -> 状态编码 -> AI 模型 -> 决策 -> 行动这个工作流与 Python 中完美对齐。
最后,大功告成!获得了一个可以与 AI 对战的 Web 版《情书》。